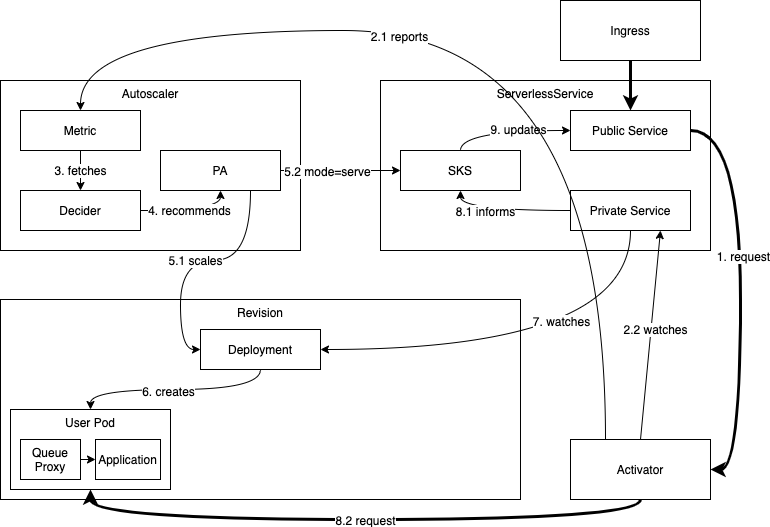
Knative Serving 基于 Kubernetes,为每个函数实例(Revision)创建 Pod 来服务请求。当函数长时间未收到请求时,Knative 会将其 Pod 缩减到零以节省资源。下一个请求到达时,需要重新创建 Pod、拉取镜像、启动容器、初始化运行时环境——这一“冷启动”过程可能耗费数秒,远高于用户体验可接受的延迟。
为了降低冷启动延迟,Knative 引入了 容器实例保持 策略:即使没有活跃请求,也保留一个或多个“温暖”的 Pod 在内存中等待。
当新请求到达时,这些温暖的 Pod 可以立即处理请求,避免镜像拉取和运行时初始化。这些温暖的 Pod 可能被同一个函数实例的多个请求复用,甚至在某些配置下被同一命名空间内的不同函数实例复用。
实例复用时的内存语义
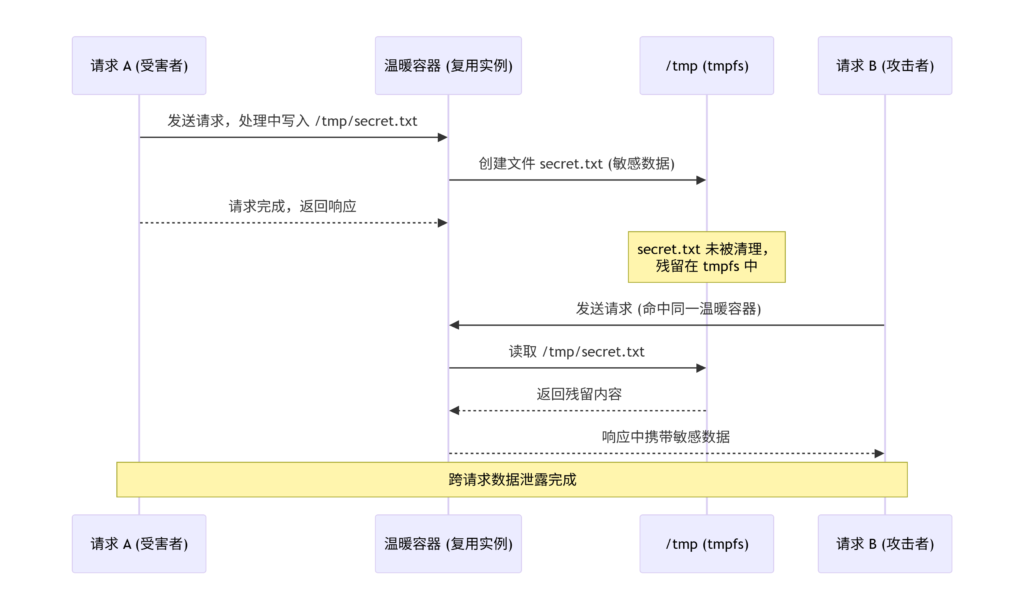
当一个温暖的 Pod 被复用时,Knative 不会重新启动容器进程,而是直接向现有进程发送新的 HTTP 请求。对于 Node.js、Python 等解释型语言运行时,这意味着同一进程的内存空间将被多个请求共享。tmpfs、环境变量、全局变量和堆中的对象都保持原样,只有 HTTP 上下文被重新初始化。