eBPF 程序间隐蔽信道

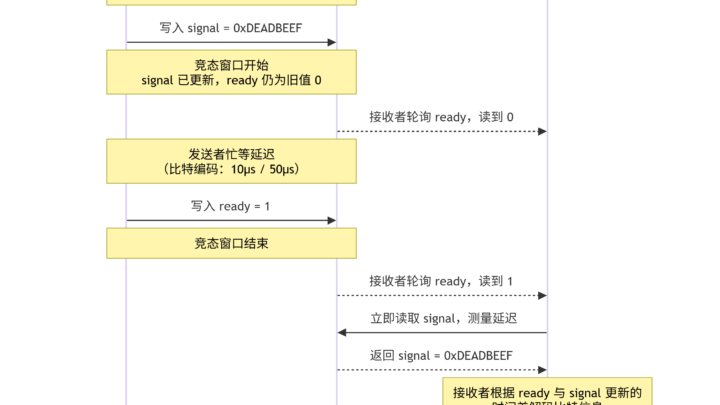
摘要 eBPF 映射为内核态程序提供了高效的数据交换机制,其原子性保证仅限于单个 64 位操作。当多个 eBPF 程序共享同一个 BPF_MAP_TYPE_ARRAY 或 BPF_MAP_TYPE_HASH 时,涉及多个映射字段的复合操作存在天然的竞态窗口。攻击者可在一个容器的 eBPF 程序中快速修改映射的多个字段,与此同时,另一个容器的 eBPF 程序在读取前观察到不一致的中间状态,从而建立基于时序的隐蔽信道,绕过容器网络隔离与安全策略。更关键的是,bpf_spin_lock 的适用范围有限——它仅保护映射值内部字段的原子性,无法阻止攻击者利用映射操作之间的竞态。 eBPF 映射的并发语义 原子性保证的边界 eBPF 映射是内核中存储键值对的数据结构,支持 BPF_MAP_TYPE_ARRAY、BPF_MAP_TYPE_HASH、BPF_MAP_TYPE_PERCPU_ARRAY 等多种类型。对于哈希映射,bpf_map_update_elem 和 bpf_map_lookup_elem 在单个条目上提供原子读写——这意味着一个 64 位的值在任一时刻要么被完全写入,要么被完全读出,不会出现撕裂读写。 然而,复合操作的原子性并不存在。当攻击者需要同时修改两个或多个映射条目,或者在一个映射条目上执行“读取-修改-写入”序列时,多个指令之间存在可被其他程序观察到的窗口。例如: // 非原子复合操作 __u64 *counter = bpf_map_lookup_elem(&stats_map, &key); if (counter) { __u64 old = *counter; *counter = old + 1; // 读-改-写 竞态 __u64 *timestamp = bpf_map_lookup_elem(&time_map, &key); if (timestamp) { *timestamp = bpf_ktime_get_ns(); // 与 counter…
镜像仓库幻影层

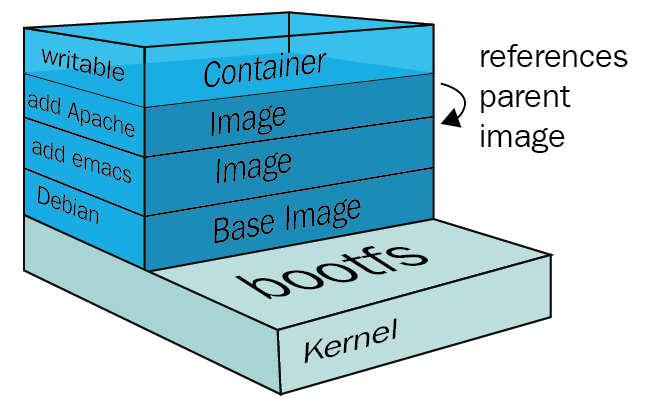
摘要 OCI 镜像以层为单位分发,每层通过 tar 包与白文件(whiteout)控制文件删除与覆盖。容器运行时在解压镜像时,runc 的 mountToRootfs 会逐层应用变更,此过程对符号链接的处理存在边界歧义:攻击者可构造恶意镜像,先创建指向宿主根目录的符号链接,再利用后续层的挂载与白文件操作,绕过文件系统的访问控制,在容器启动阶段完成宿主机文件系统的逃逸。 OCI 镜像与容器运行时基础 镜像分层与 tar 层 OCI 镜像由多个只读层叠加而成,每一层是一个 tar 归档,保存相对于根文件系统的变化。镜像构建时,每个 RUN、ADD 等指令会生成一个新的层,最终通过联合文件系统(如 OverlayFS)合并成一个完整的根文件系统视图。 容器启动时,containerd 调用 runc 创建容器。runc 根据 OCI 配置,先挂载根文件系统(通常是 overlay),然后执行 rootfs 的准备工作,包括处理各层的文件操作。 runc 的 mountToRootfs 流程 runc 的 libcontainer/rootfs_linux.go 中,mountToRootfs 负责将各层挂载到容器的根文件系统路径。 流程大致如下: 挂载根文件系统(例如通过 overlay)到临时目录或直接使用 pivot_root。 应用各层:对于每个镜像层,runc 会遍历 tar 包中的条目,执行创建、修改、删除等操作。 处理 whiteout 文件(.wh. 前缀)和 opaque 目录文件(.wh..wh..opq)以隐藏或删除底层内容。 挂载卷、设备等。 在应用层的过程中,runc 会处理符号链接。具体逻辑在 mountToRootfs 中调用 mountToRootfs 的辅助函数 doMount,并依赖 os.Lstat 和 os.MkdirAll 等。对于符号链接,runc 可能在某些路径上直接跟随链接,导致对宿主机文件系统的意外操作。 符号链接与白文件的滥用 符号链接的跟随与逃逸 OCI 镜像的 tar 包可以包含符号链接。如果攻击者在一个层中创建一个指向宿主根目录(例如 /)的符号链接,然后在后续层中通过该符号链接写入文件,由于解压过程通常在宿主命名空间中执行(在挂载命名空间隔离之前),写入操作可能逃逸到宿主机文件系统。 runc 在处理各层时,会先应用层的 tar 包到容器的 rootfs 目录。这个过程发生在 pivot_root 之前,此时 rootfs 是一个宿主机路径(例如 /var/lib/containerd/rootfs/…)。如果 tar 包中包含符号链接并指向 /,那么后续在该符号链接下的写入操作可能影响到宿主机根目录。 白文件清空机制 白文件(以 .wh. 开头的文件)用于在更高层中删除低层的文件或目录。runc 在处理白文件时,会将低层的目标路径替换为删除操作。如果目标路径是一个符号链接,且该链接指向宿主目录,则删除操作可能删除宿主上的文件。 攻击者可以利用这种“删除”操作来掩盖逃逸行为,或者在逃逸后清理痕迹。 嵌套挂载与保护目录的绕过…

GPU 着色器核心的寄存器文件静默错误

摘要 现代 GPU 的寄存器文件在高频率和低电压下容易出现瞬态故障,NVIDIA Hopper 架构虽引入 ECC 保护,但 ECC 仅在寄存器被读取时检测错误,对于在计算单元间共享的寄存器,错误可能在写入时潜伏,传播至后续的矩阵运算。攻击者可通过操纵 GPU 供电(利用 NVML 调整功耗限制)或利用相邻 SM 的发热效应,诱发特定寄存器的位翻转,篡改大型语言模型的推理权重或注意力分数,导致输出可控偏差。更危险的是,这种攻击不需要任何软件漏洞——它直接在硬件层面进行,传统的安全监控工具完全失明。 GPU 寄存器文件 寄存器文件的微架构特性 GPU 的寄存器文件是 SM(流式多处理器)中容量最大、访问最频繁的片上存储结构。与 CPU 不同,GPU 采用大规模线程并行架构,每个 SM 包含数十万个寄存器,以支持数千个并发线程的快速上下文切换。为了在有限的芯片面积内实现如此巨大的寄存器容量,GPU 制造商使用了高密度 SRAM 单元,这些单元的工作电压接近晶体管的阈值电压。 这种设计带来两个直接后果:功耗极高,以及对电压波动和温度变化极其敏感。当寄存器文件在高负载下持续读写时,局部温度可能比芯片平均值高出 15-20°C,进一步降低噪声容限。如果此时供电电压发生瞬态跌落,某些寄存器单元可能发生位翻转——写入和读出之间的数据发生静默变化。 ECC 的检测缺口 为了应对瞬态故障,NVIDIA 在 Hopper 架构的寄存器文件中引入了 ECC 保护。ECC 能够在寄存器被读取时检测和纠正单比特错误,并检测双比特错误。然而,ECC 的保护存在一个关键的时间窗口缺口: ECC 校验发生在寄存器读取时,而非写入时。 如果一个位翻转发生在寄存器写入之后、读取之前,ECC 能够检测到。但如果位翻转发生在写入之前——即攻击者在数据被加载到寄存器之前就篡改了数据——ECC 将无从知晓,因为它只验证数据在存储期间的完整性,而非数据本身的正确性。 Clock (CLK) __递增沿__/ __递增沿__/ __递增沿__/ | | | WADDR…

ARM64 GIC时序侧信道

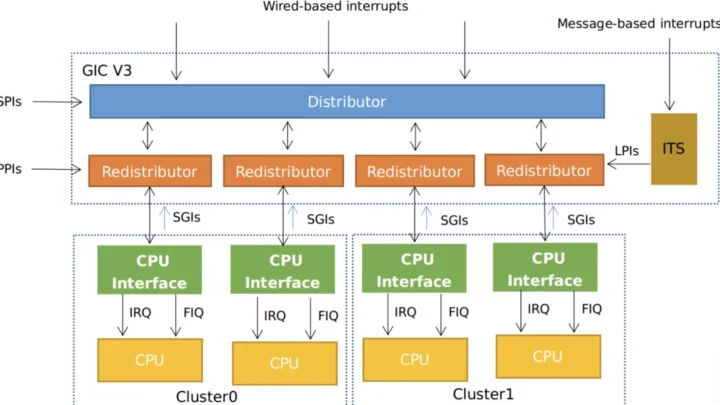
摘要 ARM64 通用中断控制器在分发硬件中断时,会短暂挂起当前执行的指令流。在核心保存上下文期间,被中断的指令序列可能已经执行了部分加载指令,将敏感数据预取到 L1 数据缓存。攻击者若能够控制中断到达的精确时机(例如通过软件生成的中断 SGI),可在安全世界(EL3)的关键指令(如 eret)执行前中断它,使预加载的安全世界缓存行在普通世界可被探测,从而绕过 TrustZone 的隔离,窃取安全世界的加密密钥或敏感数据。 GIC 与 ARM64 异常入口的时序窗口 GICv3 中断分发路径 ARM64 平台的通用中断控制器(GIC)负责管理所有中断源,并向 CPU 核心分发。GICv3 由分发器(Distributor)和再分发器(Redistributor)以及 CPU 接口组成。软件生成中断(SGI)通过写 ICC_SGI0R_EL1 或 ICC_SGI1R_EL1 寄存器来触发,可指定目标核心和中断 ID。攻击者如果具备在普通世界 EL1 的代码执行能力,便可以向自身或其他核心注入 SGI,制造精确的本地中断。 当中断到达核心时,CPU 完成当前指令的边界,然后进入异常入口流程:保存处理器状态到栈,跳转到中断向量。ARM64 的中断向量表定义了不同异常级别和类型的入口。关键点是,从异常被触发到第一条异常处理指令执行之间存在固定的指令流水线延迟,并且在这个窗口内,处理器可能已经执行了后续的部分指令(由于分支预测和推测执行)。 安全世界与普通世界的切换 在 TrustZone 架构中,普通世界(Normal World)和安全世界(Secure World)的切换通过 smc 指令进入 EL3,或在 EL3 中通过 eret 返回普通世界。当安全世界正在执行敏感操作(如加密、认证)时,若被中断抢占,处理器必须先保存安全世界上下文,然后跳到中断处理程序。如果该中断处理程序位于普通世界(例如在 EL1 内核中),则会进行一次世界切换(从安全世界到普通世界),这涉及缓存和 TLB 的维护操作。 [EL0 用户态代码] │ ├─ (发生异常/中断, 如 SVC / IRQ) ▼ [硬件自动行为 (CPU Core)] ├─…

AMD Inception++

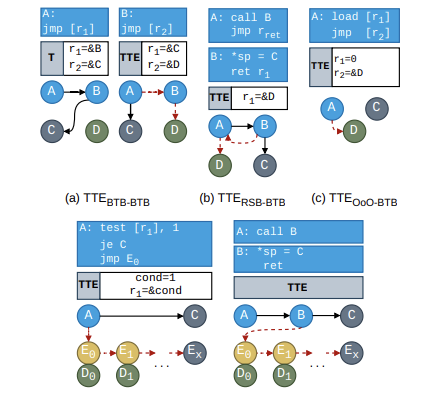
摘要 AMD Zen 4 架构引入增强的返回栈缓冲区预测机制,其 RSB 深度仅 32 条,且回填策略在 RSB 下溢时依赖 BTB 预测。安全研究人员在 2024 年发现,Zen 4 的 RSB 下溢行为与 BTB 训练之间的交互存在根本性裂缝:攻击者可构造深层调用链使 RSB 耗尽,随后用精心布局的间接跳转训练 BTB,使 RSB 下溢预测跳转到攻击者控制的 Spectre 小工具。该攻击可绕过 Zen 4 的 IBPB 缓解,因为 RSB 操作与 BTB 训练不在同一清理路径。 Zen 4 分支预测器的微架构景观 返回栈缓冲区 返回栈缓冲区(RSB)是高性能处理器中用于预测 RET 指令目标的专用预测器。当 CPU 执行 CALL 指令时,将返回地址(即 CALL 之后的下一条指令地址)压入 RSB;当执行 RET 指令时,从 RSB 弹出顶部条目作为预测目标。这种机制使得函数返回预测的精度极高——正常情况下,CALL 与 RET 严格配对,RSB 的栈结构天然匹配调用约定。 +—————————————+ <– 硬件栈底 (Bottom) | Entry [N-1]…