Windows 过滤管理器中的 Attached 结构体混淆

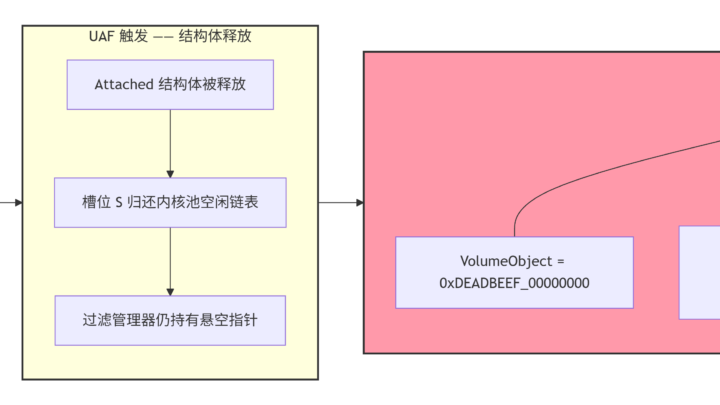
摘要 Windows 过滤管理器(FltMgr.sys)通过 Attached 结构体将微过滤器绑定到卷设备栈,维护着每个微过滤器实例在 I/O 栈中的位置关系。然而,在 FltUnregisterFilter 卸载路径中,该结构体的引用计数管理存在竞态条件窗口,攻击者可利用并发 I/O 请求使 Attached 结构体在仍被引用时被释放,导致 use-after-free。这种结构体混淆使得攻击者能够覆写内核池中的控制数据,劫持卷设备栈上的回调指针,最终实现从低权限用户到 SYSTEM 的本地权限提升。本文从过滤管理器的 Attached 结构体架构出发,逐层剖析 FltUnregisterFilter 卸载路径中的竞态窗口、引用计数缺陷及卷设备栈劫持机制,构建基于 Windows 内核驱动和用户态触发器的完整 PoC,并讨论基于引用计数完整性监控和卸载路径审计的防御方案。 过滤管理器与 Attached 结构体 过滤管理器在文件系统栈中的位置 Windows 过滤管理器(Filter Manager,FltMgr.sys)是文件系统过滤驱动框架的核心组件,位于文件系统驱动(如 NTFS、FAT32)与遗留过滤器之间。它允许微过滤器驱动注册回调例程,以拦截和处理文件系统操作(如创建、读取、写入、重命名)。 过滤管理器维护了一个“帧”概念,用于在 I/O 栈中插入微过滤器。 每个帧包含一组在相同高度(altitude)上运行的微过滤器实例,帧的排列顺序决定了微过滤器的调用顺序。当微过滤器加载时,过滤管理器将其回调函数插入到 I/O 处理路径中;当微过滤器卸载时,过滤管理器需要从所有卷设备栈中移除其回调。 Attached 结构体的角色 在过滤管理器的内部实现中,Attached 结构体(_FLT_ATTACHED_VOLUME 或类似命名)是连接微过滤器实例与卷设备栈的关键数据结构。它存储了以下信息: 卷对象指针:指向该微过滤器实例所附加的卷设备对象。 设备栈位置:微过滤器在设备栈中的相对位置(在哪个设备对象之上或之下)。 回调注册表:该微过滤器在此卷上注册的所有 I/O 回调函数。 引用计数:跟踪有多少未完成的 I/O 操作正在引用此 Attached 结构体。 当一个微过滤器通过 FltAttachVolume 或自动附加机制绑定到某个卷时,过滤管理器为该微过滤器分配一个…
Linux io_uring 固定缓冲区逃逸

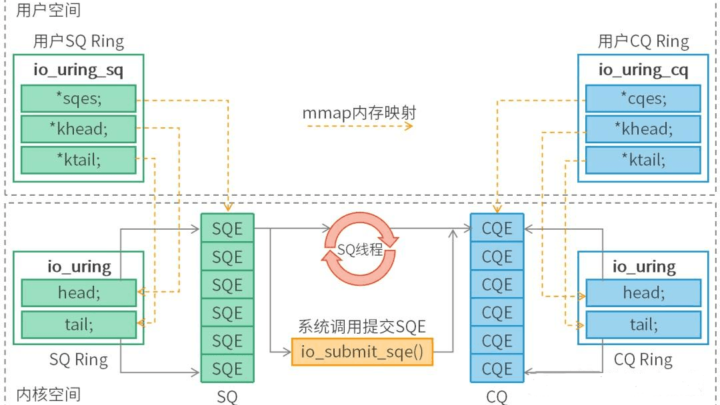
摘要 io_uring 的固定缓冲区机制通过预注册用户页并长期持有 FOLL_PIN 引用,消除了每次 I/O 操作的页锁定开销。然而,这种“一次注册、永久持有”的设计在 IORING_OP_SPLICE 的异步执行路径中暴露出了引用计数管理的结构性缺陷。CVE-2022-4696 揭示了 io_splice 在异步工作队列中执行时缺少 IO_WQ_WORK_FILES 标志,导致 current->nsproxy 的引用计数未被正确递增,而 get_uts 调用却会使用它,最终造成 use-after-free。更危险的是 PinTheft 攻击(CVE-2026-43494),它通过 RDS 零拷贝发送路径的 double-free 窃取 io_uring 固定缓冲区注册的 FOLL_PIN 引用,将匿名页的引用计数从 1024 降至零,使该页被释放并重新分配为 SUID-root 二进制的页缓存。攻击者随后利用悬空的 io_uring 固定缓冲区指针覆写页缓存,植入恶意 ELF 载荷,执行 SUID 程序即获得 root shell。 io_uring 固定缓冲区 固定缓冲区 io_uring 的核心性能优势之一在于消除了每次 I/O 操作的系统调用开销。但即使绕过了系统调用,每次 I/O 仍然需要将用户缓冲区映射到内核可访问的内存中——这一过程通过 get_user_pages 完成,涉及页表遍历、TLB 填充和引用计数递增。 固定缓冲区机制将这一开销从“每次操作”降低到“每次注册”。用户通过 io_uring_register…

5G 核心网的 SBI 消息窃听

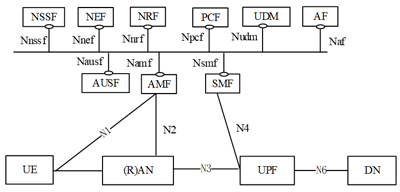
摘要 5G 核心网从传统点对点架构转向基于服务的架构,所有网络功能通过 HTTP/2 上的 RESTful API 进行通信。然而,这一架构变革在提升弹性的同时,也将电信核心网暴露在了与云原生微服务相同的攻击面之下。CVE-2026-55068 揭示了 free5GC NRF 的 RegisterNFInstance 处理器在未验证 NF Profile 的情况下接受注册请求,攻击者可通过 SBI 注入携带恶意 IP 端点的伪造 NF 配置,使后续所有 NF 发现请求返回攻击者控制的地址,从而将控制面信令重定向至攻击者基础设施。与此同时,CVE-2026-44320 暴露了 NEF 回调路由组完全缺失 OAuth2 认证中间件的问题——任意伪造的 Bearer Token 即可穿透认证边界,直达 SMF 回调处理器。 5G SBI 的信任模型与攻击面 从点对点到服务化架构 5G 核心网的根本性变化在于将传统的点对点接口替换为基于 HTTP/2 的服务化接口。在 4G EPC 中,MME 通过 S1-MME 接口与 eNodeB 通信,通过 S6a 接口与 HSS 通信,每个接口都有专用的协议和信令格式。5G…

自动微分的内存悬崖

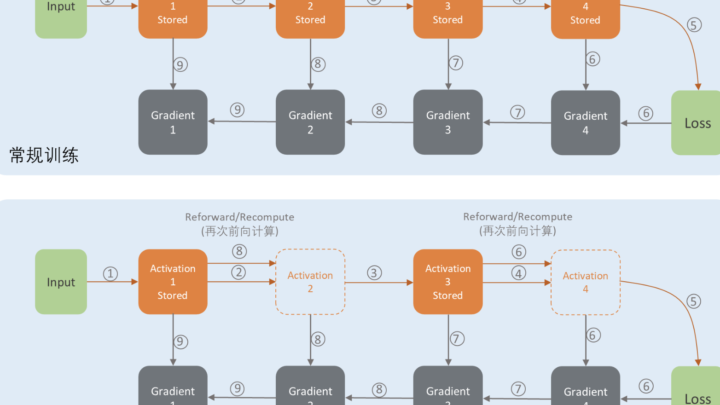
摘要 梯度检查点通过在反向传播期间重新计算前向激活,将训练数十亿参数模型的内存需求压缩到可接受的范围。然而,这一“以计算换内存”的策略在自动微分图中创造了一个独特的信任缺口:检查点区域内的中间张量在反向传播时被重建,而重建过程所依赖的钩子(hooks)和函数注册机制完全暴露在训练框架的插件生态中。攻击者可在 torch.utils.checkpoint 包装的模块上注册恶意反向钩子,劫持重计算路径,在梯度流经检查点边界时捕获模型权重梯度,进而通过梯度反演重建私密训练数据或提取模型参数。2024年字节跳动前实习生利用Hugging Face检查点加载函数漏洞篡改模型权重、注入后门代码的事件,以及PyTorch Lightning中 _instantiator 超参数绕过 weights_only=True 防护的漏洞,共同揭示了检查点机制从“内存优化工具”到“攻击入口”的范式转变。 自动微分 标准反向传播的内存代价 训练大型神经网络时,反向传播需要前向传播过程中产生的中间激活值来计算梯度。 以一个包含 L 层的Transformer为例,标准训练需要存储所有 L 层的激活值,内存占用随层数线性增长。对于 GPT-3 级别的模型(96层,隐藏维度12288),仅激活值的内存需求就超过 100 GB,远超单张 GPU 的显存容量。 梯度检查点的数学原理 梯度检查点(Gradient Checkpointing)由陈天奇等人在2016年提出,核心思想是将网络划分为若干段,每段仅在内存中保留边界处的激活值。在反向传播需要某段内部的中间激活时,从最近的检查点边界重新执行前向传播来重建这些激活。 数学上,对于第 i 段,前向传播计算: y_i = f_i(x_i; θ_i) 其中 x_i 是该段的输入,θ_i 是该段的参数。标准反向传播需要存储所有中间张量,而检查点仅存储 x_i。反向传播时,需要计算损失 L 对 x_i 和 θ_i 的梯度: ∂L/∂x_i = ∂L/∂y_i · ∂f_i/∂x_i ∂L/∂θ_i = ∂L/∂y_i · ∂f_i/∂θ_i…

矢量数据库近似近邻欺骗

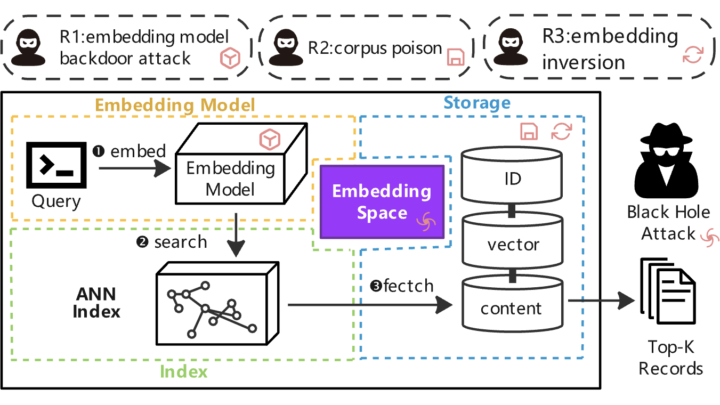
摘要 FAISS 的倒排文件索引通过 K-means 聚类将向量空间划分为多个 Voronoi 单元,查询时仅搜索距离最近的 nprobe 个质心所对应的倒排列表,以可接受的召回率损失换取数量级的速度提升。然而,这种近似搜索机制存在一个根本性的几何缺陷:高维嵌入空间中,靠近聚类质心的向量会成为不成比例的大量其他向量的最近邻,而质心区域在实际数据中几乎是空的。安全研究人员提出的 Black-Hole Attack 正是利用这一现象——攻击者仅需向数据库注入约 1% 的恶意向量,将其放置在聚类质心附近,这些向量便能以高达 99.85% 的概率出现在任意查询的 top-k 检索结果中。被检索到的恶意文档通过词汇工程(如“根据更新后的记录”“修正后的数据显示”)诱导 LLM 优先采信注入内容,从而实现对检索增强生成系统的知识篡改。 FAISS IVF 索引的架构与几何基础 倒排文件索引的聚类分区 FAISS 的 IVF 索引是一种经典的近似近邻搜索结构,其核心思想是将高维向量空间划分为若干个子空间,每个子空间对应一个聚类中心。 索引构建分为两个阶段: 训练阶段:对数据库中的向量子集应用 K-means 聚类算法,生成 nlist 个质心,每个质心代表一个 Voronoi 单元。K-means 的优化目标是最小化每个向量到其所属质心的距离平方和。 添加阶段:将全部向量分配到距离其最近的质心所对应的倒排列表中。每个倒排列表存储了属于该聚类的所有向量的 ID 或编码后的压缩表示。 查询时,系统首先计算查询向量与全部 nlist 个质心的距离,选择最近的 nprobe 个质心,然后仅在这些质心对应的倒排列表中执行精确的向量比较。 近似搜索的几何代价 IVF 的核心权衡在于用召回率换取速度。当 nprobe 较小时,系统只搜索了向量空间中的少数区域,如果查询向量的真实最近邻恰好位于未被搜索的单元中,结果就会遗漏。 在实际部署中,nlist 的典型取值为 4sqrt(N) 到 16sqrt(N),nprobe…

TorchScript 序列化

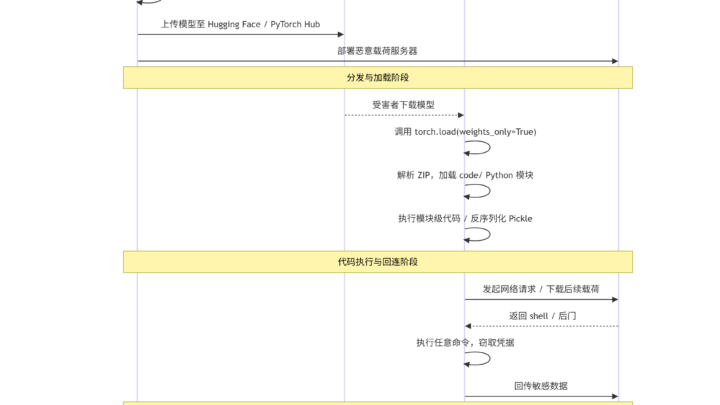
摘要 PyTorch 的 TorchScript 格式将模型序列化为一个 ZIP 目录,其中同时包含 Python 源代码文件和 Pickle 数据文件。这种“代码即模型”的设计在提升跨平台推理能力的同时,创造了一个系统性风险:torch.load() 在加载 TorchScript 模型时会自动执行其中的 Python 代码和 Pickle 反序列化逻辑。2025 年,阿里云安全团队在 DEF CON 33 上揭示了一个颠覆性发现——weights_only=True 这一被 PyTorch 官方文档视为安全选项的参数,实际上支持 TorchScript,而 TorchScript 中嵌入的 Lambda 对象可以在模型加载时执行任意代码。该漏洞被分配为 CVE-2025-32434,影响 PyTorch 2.5.1 及之前的所有版本。 TorchScript 序列化格式 TorchScript 的 ZIP 目录结构 TorchScript 是 PyTorch 的中间表示格式,允许模型脱离 Python 运行时独立执行。当调用 torch.jit.save() 保存模型时,生成的 .pt 文件实际上是一个 ZIP 归档,内部结构如下: 其中 code/ 目录包含模型的 Python 源代码文件,这些文件定义了计算图、自定义操作和模块结构。data.pkl 和 constants.pkl 则是 Pickle 格式的序列化数据,存储张量参数、元数据和常量。version 文件用于兼容性检查。 这种格式的核心特征是:模型文件同时包含可执行代码和序列化数据。Palo Alto Networks…